Complete your purchase
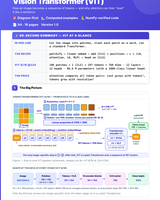
Vision Transformer (ViT) – Visual Mental Models & Architecture Guide
4.99 €
A visual guide to Vision Transformers (ViT), explaining image patches, token embeddings, positional encoding, multi-head attention, Transformer encoder blocks, and image classification through diagrams, computed examples, and NumPy code.
PDF · 16 pages · English · Intermediate
Secure payment
via Stripe Checkout
Instant delivery
Download after payment
No account needed
Guest checkout